この記事は、SEO・LLMO対策への支援実績を持つHabinyのコンサルタントが、公式情報と支援事例をもとに執筆しています。
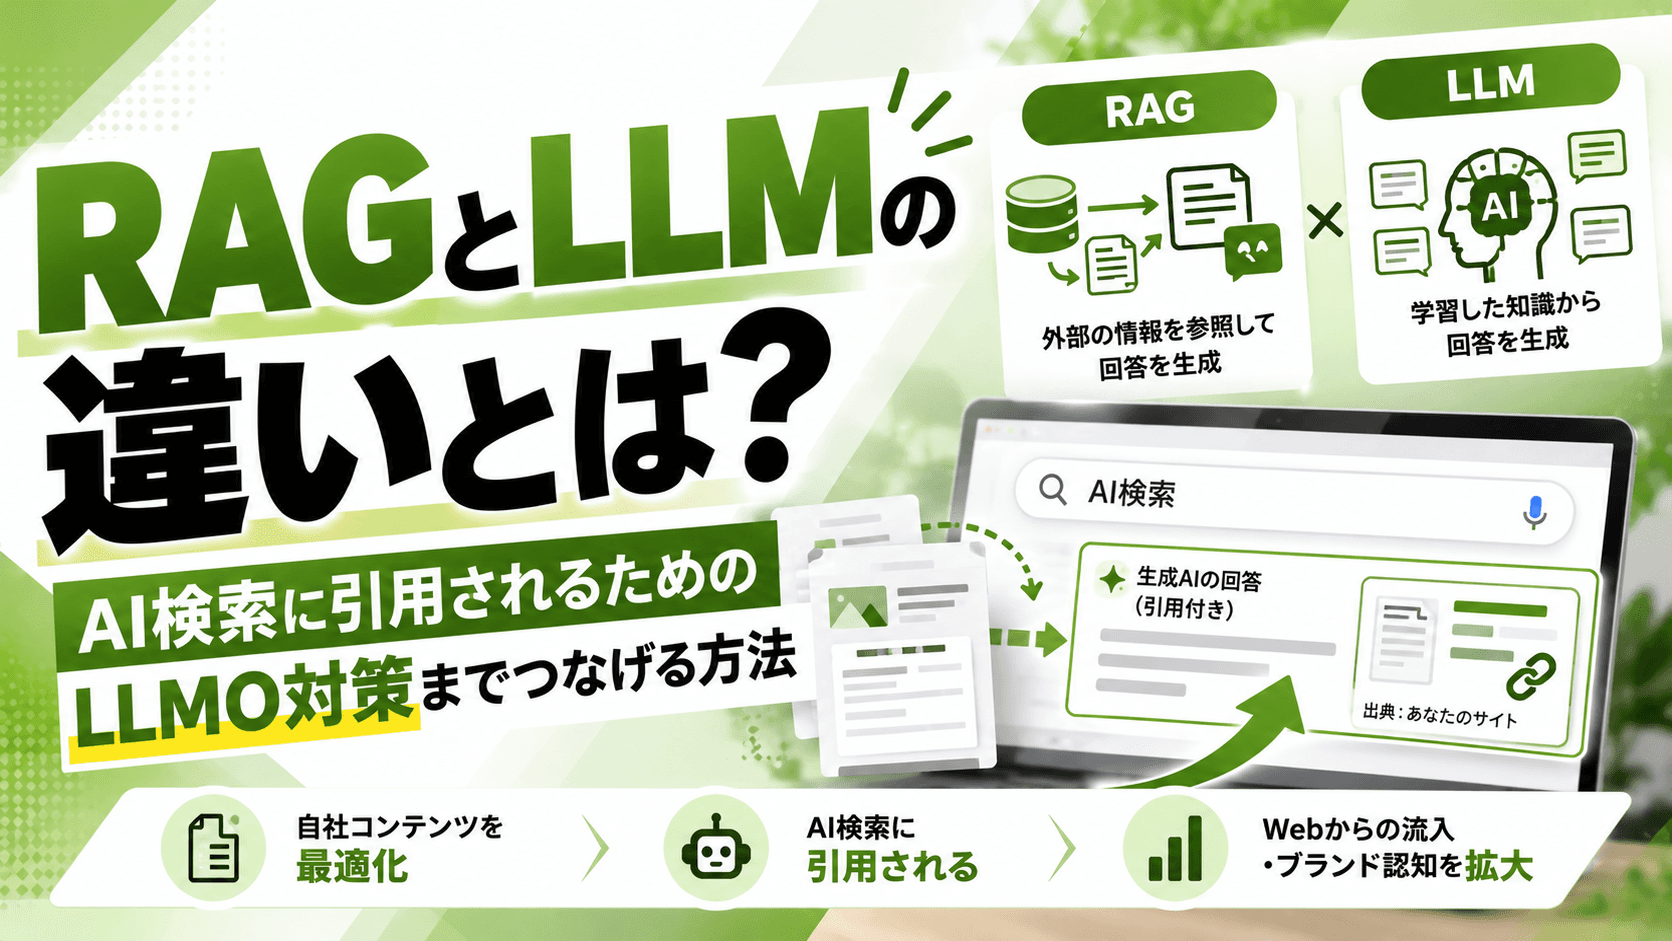
「RAGとLLMは何が違うのか」。生成AIの導入を検討する中で、この疑問を持つ方は多いはずです。答えを先に言うと、LLMは文章を生み出す「頭脳」、RAGはその頭脳に「調べてから答えさせる」仕組みです。そして、この仕組みは社内のAI活用だけの話ではありません。GoogleのAI Overview(AIによる概要)やChatGPTの検索機能も、検索で集めた情報をもとに回答を生成しています。つまりRAGを理解することは、AI検索で自社が「引用される・されない」理由を理解することでもあります。本記事では、RAGとLLMの違いと仕組みを整理したうえで、B2Bマーケターが押さえるべき活かし方までを解説します。
💡この記事でわかること
- RAGとLLMの違い・役割分担と、質問から回答が生成されるまでの4ステップ
- GoogleのAI検索やChatGPTの検索機能が、RAG型の仕組みで情報を集めて回答していること
- AI検索に引用されやすいコンテンツの条件と、マーケティング部門で社内RAGを活用する手順
【AIに「選ばれる」企業へ。】
RAGとLLMの違いとは?結論は「記憶だけで答えるか、調べてから答えるか」
LLMは学習済みの知識だけで文章を生成するAIモデル、RAGはLLMが回答する前に外部のデータを検索し、その内容を根拠に答えさせる仕組みです。両者は対立するものではありません。RAGはLLMを置き換えるのではなく、LLMの弱点を補うために組み合わせて使います。試験に例えると、LLM単体は「記憶だけで解く試験」、RAGは「資料の持ち込みが許された試験」です。
LLM(大規模言語モデル)とは
LLM(Large Language Model)は、大量のテキストを学習し、人間が書いたような自然な文章を生成できるAIモデルです。ChatGPTのGPTシリーズ、Gemini、Claudeなどが代表例です。
文章作成・要約・翻訳・アイデア出しなど幅広い作業に使える一方、知識は学習した時点までに限られます。また、社内資料のように学習していない情報は答えられず、事実と異なる内容をもっともらしく出力する「ハルシネーション」が起きることもあります。
RAG(検索拡張生成)とは
RAG(Retrieval-Augmented Generation)は、日本語で「検索拡張生成」と訳されます。質問を受けたら、まず社内文書やWebなどの外部データから関連する情報を検索し、その情報をLLMに渡して回答を生成させる仕組みです。
比較表:LLM単体/RAG/ファインチューニングの違い
LLMに自社の知識を持たせる方法には、RAGのほかに「ファインチューニング(追加学習)」があります。導入を判断する際は、3つを並べて比べると違いが明確になります。
観点 | LLM単体 | RAG | ファインチューニング |
|---|---|---|---|
知識の出どころ | 学習済みのデータのみ | 学習済みのデータ+回答のたびに検索した外部データ | 追加学習でモデル自体に取り込んだデータ |
最新情報への対応 | 学習時点まで | 参照データを更新すればすぐ反映できる | 再学習しないと反映されない |
回答の根拠 | 示しにくい | 参照した文書を示せる | 示しにくい |
導入の手間 | 小さい | 参照データの整備と検索の仕組みが必要 | 学習用データの準備と計算資源が必要 |
向いている用途 | 文章作成、要約、翻訳、アイデア出し | 社内FAQ、規程・マニュアル検索、最新情報にもとづく回答 | 特定の文体・出力形式への最適化、専門的な定型タスク |
「社内の情報を正しく答えさせたい」「情報が頻繁に変わる」という目的なら、まずRAGを検討するのが一般的です。ファインチューニングは知識を足すよりも、話し方や出力の型を整える用途に向いています。
RAGの仕組み:質問から回答までの4ステップ
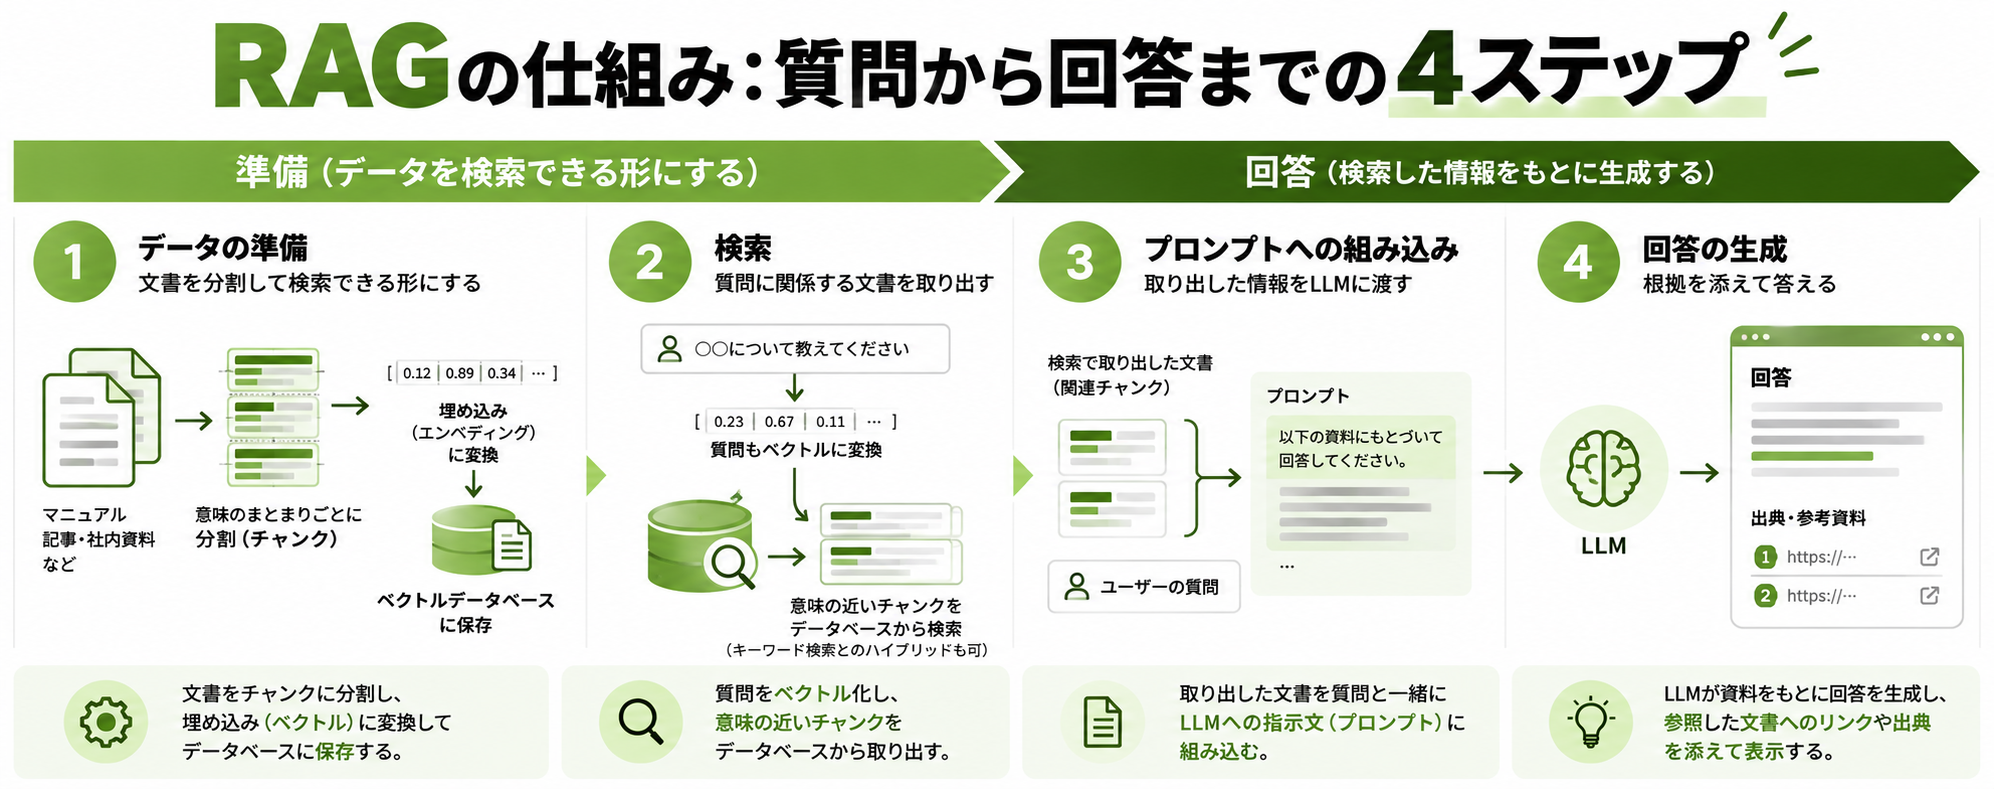
RAGは「準備」と「回答」の2つの段階に分かれ、細かく見ると次の4ステップで動きます。エンジニアでなくても、この流れを押さえておけば導入の打ち合わせで判断に迷いません。
① データの準備:文書を分割して検索できる形にする
マニュアルや記事などの文書を、意味のまとまりごとの小さな単位(チャンク)に分割します。次に、各チャンクを「埋め込み(エンベディング)」と呼ばれる数値の並び(ベクトル)に変換し、データベースに保存します。こうしておくと、言葉が完全に一致しなくても「意味が近い文書」を探せるようになります。
② 検索:質問に関係する文書を取り出す
ユーザーの質問も同じようにベクトルに変換し、意味の近いチャンクをデータベースから取り出します。キーワードの一致で探す従来型の検索を組み合わせる方法(ハイブリッド検索)もあります。回答の質はこの段階で大きく左右されます。
③ プロンプトへの組み込み:取り出した情報をLLMに渡す
取り出した文書を、質問と一緒にLLMへの指示文(プロンプト)に組み込みます。「以下の資料にもとづいて回答してください」といった指示を加えることで、LLMが手元の資料を根拠に答えるよう誘導します。
④ 回答の生成:根拠を添えて答える
LLMが、渡された資料と自身の言語能力を使って回答を生成します。参照した文書へのリンクや出典を添えて表示すれば、利用者が根拠を確かめられます。
RAGを使うメリットと欠点
メリット
- 最新の情報や社内固有の情報にもとづいて回答できる
- 根拠となる資料を渡すため、ハルシネーションを抑えやすい
- 参照元を示せるので、回答の正しさを人が確認しやすい
- 情報が変わっても、参照データを差し替えるだけでモデルの再学習が要らない
欠点・限界
- 検索で的外れな文書を取り出すと、回答も的外れになる(検索の精度に依存する)
- 参照データが古い・重複している・表記がばらばらだと精度が落ちるため、データの整備と更新の体制が欠かせない
- 閲覧権限のない情報が回答に混ざらないよう、アクセス権の管理が必要になる
- 検索の工程が加わる分、LLM単体より応答に時間がかかることがある
ハルシネーションは「抑えやすくなる」のであって、ゼロにはなりません。特に数値や固有名詞を含む回答は、参照元を人が確認する運用を前提にしましょう。
【AIに「選ばれる」企業へ。】
【マーケター必見】AI検索はRAG型で動いている——「引用されるか」は検索段階で決まる
ここからが、B2Bマーケターにとって本題です。RAGの「検索してから生成する」流れは、社内ツールだけでなく、見込み顧客が日常的に使うAI検索にも組み込まれています。
GoogleのAI検索とChatGPTの検索機能はどう回答を作っているか
Googleは2026年5月に公開した生成AI検索向けの公式ガイドで、AI OverviewやAIモードの仕組みを説明しています。中心にあるのが、RAG(Googleは「グラウンディング」とも呼ぶ)です。コアとなるランキングシステムを使ってインデックスから関連するページを取り出し、その内容をもとに回答を生成します。あわせて、1つの質問を関連する複数の質問に分けて同時に検索する「クエリ・ファンアウト」も使われます。
出典:Google 検索セントラル「Google 検索の生成 AI 機能向けにウェブサイトを最適化する」(RAG・クエリ・ファンアウトの説明/2026年10月24日確認)
ChatGPTの検索機能も同じ流れです。OpenAIのヘルプによると、ChatGPTは質問を1つ以上の検索クエリに書き換えて検索し、得られた結果を使って、情報源へのリンク付きで回答を生成します。
出典:OpenAI ヘルプセンター「ChatGPTで企業と教育機関を検索」(検索の仕組みの説明/2026年10月24日確認)
【要差し込み:画像(AI検索の回答生成フローの図解)】
つまり、AI検索の回答に自社の情報が使われるかどうかは、その前の「検索で取り出されるか」でほぼ決まるということです。取り出されなかったページは、どれほど良い内容でも回答の材料になりません。
自社情報がAIの回答に出てこない3つの理由
RAGの流れに当てはめると、AI検索で自社が出てこない理由は大きく3つに整理できます。
- 検索で取り出されていない:ページがインデックスされていない、または関連する質問で上位に表示されていないため、回答の材料の候補に入っていない。
- 取り出されても、答えになる記述がない:質問に対する結論が本文に埋もれている、定義や数値が曖昧など、回答に使いにくい書き方になっている。
- 情報源として信頼されにくい:誰が書いたか、何を根拠にしているかが不明で、他の情報源より優先される理由がない。
自社の状況がどれに当てはまるかを知るには、見込み顧客がAIに投げそうな質問を実際に試し、回答と引用元を記録するのが近道です。
関連記事:LLMO診断とは?AI検索で自社が「選ばれているか」を測る方法と見るべき指標
SEOとLLMOの関係:取り出される土台がSEO、引用される中身がLLMO
Googleは同じガイドで、生成AI検索への最適化はGoogle検索の観点では「SEOの一部」だとしています。AI検索の材料はインデックスから取り出されるため、検索で評価される状態をつくるSEOが土台になります。そのうえで、取り出された後に「回答として使いやすい中身か」「信頼できる情報源か」を磨くのがLLMO・AIOの領域です。どちらか一方ではなく、つなげて設計することが成果への近道です。
関連記事:LLMO対策とは?SEO・AIOとの違いや具体施策をわかりやすく解説
【AIに「選ばれる」企業へ。】
AI検索に引用されやすいコンテンツ設計のポイント
前提として、AIのために文章を書き換える必要はありません。Googleは、AI向けにコンテンツを細かく分割したり、AI専用の書き方に直したりする必要はなく、読者のためにページを作るべきだとしています。以下は、読者にとってわかりやすいことが、そのまま検索で取り出され、回答に使われやすいことにつながる5つのポイントです。
出典:Google 検索セントラル「Google 検索の生成 AI 機能向けにウェブサイトを最適化する」(AI向けの書き換え・分割は不要との説明)
① 検索で見つかる土台を整える
ページがインデックスされ、検索結果にスニペット付きで表示できる状態であることが出発点です。クロールを妨げていないか、重要ページが重複していないかを確認し、狙うキーワードで評価される記事を積み上げます。
② 各見出しの冒頭で結論を示す
見出しの直後に「〇〇とは、〜です」「結論は〜です」と答えを置きます。読者が答えを早く見つけられる書き方は、検索で取り出された箇所から回答をつくる仕組みとも相性がよくなります。
③ 定義・数値・手順・比較を明確に書く
「〜など」「さまざまな」で済ませず、区分・数値・判断基準・手順を具体的に書きます。比較は表に、手順は番号付きの一覧にまとめると、読者にも伝わりやすくなります。
④ 一次情報と出典で「信頼できる情報源」になる
誰でも書ける一般論の要約では、他のページより優先される理由がありません。自社の支援事例の数値、現場の判断基準、顧客からよく受ける質問への回答など、自社にしかない情報を載せ、執筆者・運営会社・出典を明記します。
関連記事:一次情報とは?二次情報・三次情報との違いと成果につなげる集め方・使い方を徹底解説
⑤ 関連する質問まで答えるコンテンツ群をつくる
クエリ・ファンアウトでは、1つの質問が関連する複数の検索に分かれます。主要なテーマについて、定義・比較・選び方・費用・事例といった周辺の質問にも記事群で答えておくと、取り出される機会が増えます。ただし、質問の言い回しごとに似たページを量産するのは避けましょう。
【実例】SEOで積み上げた記事が、AI検索経由の問い合わせにつながった
世田谷で不動産売買を手がける株式会社Tokyo & Internationalは、Habinyとともに地域・ライフイベント別のキーワードにもとづく記事制作と、弁護士監修による専門性の高いコンテンツづくりに取り組みました。その結果、約8ヶ月で月間アクティブユーザー数が2倍超に伸び、オウンドメディア経由の売却相談も年1回から月1回ペースへと増えています。さらに、「AIで検索して同社を知り、問い合わせた」という顧客も現れました。
AI専用の特別な施策ではなく、検索で評価される記事と専門性の積み上げが、AI検索での接点にもつながった例です。RAG型の仕組みを踏まえると、自然な結果だといえます。
【実績の記事はこちら】
8ヶ月で月間ユーザー2倍超。地域密着の不動産会社がオウンドメディアで変えた集客の仕組み
社内でRAGを活用する方法:マーケ部門での使い方と導入ステップ
RAGは、マーケティング部門の業務効率化にも使えます。ここでは、大がかりなシステム開発を前提にせず、マーケ担当者が企画段階で押さえるべき要点を整理します。
マーケ部門での活用例
用途 | 参照させるデータの例 | 期待できること |
|---|---|---|
過去の資産の検索 | 公開済みの記事、導入事例、提案書、セミナー資料 | 「〇〇業界の事例は?」に根拠付きで即答でき、企画や営業資料の作成が速くなる |
問い合わせ対応の下書き | サービス資料、料金表、よくある質問 | 回答のばらつきを減らし、一次対応の時間を短縮できる |
制作ルールの確認 | 表記ルール、トンマナ、入稿マニュアル | 外部ライターや新任担当者も同じ基準で確認できる |
導入の5ステップ
- 目的と対象業務を決める:誰が、どの質問に、どのくらいの頻度で困っているかを洗い出し、効果を測る指標(回答時間、対応件数など)を決める。
- 参照データを選び、整える:古い資料や重複を除き、最新版をそろえる。表記の揺れや更新の担当者も決めておく。
- 実現方法を選ぶ:下表の3つの選択肢から、データの機密性・予算・社内の開発体制に合うものを選ぶ。
- 精度を検証する:想定される質問のリストを作り、回答の正しさと参照元を人が確認する。誤りの多い質問は、データ側の不足や分け方を見直す。
- 運用と改善を回す:参照データの更新ルールを決め、利用ログからよくある質問や答えられなかった質問を拾って改善する。
実現方法の3つの選択肢
選択肢 | 特徴 | 向いているケース |
|---|---|---|
生成AIサービスのファイル参照・社内データ連携機能を使う | 開発不要ですぐ試せる。細かな検索精度の調整はしにくい | まず小さく効果を確かめたい |
RAG機能を備えた業務向けSaaSを導入する | 権限管理や管理画面が整っている。月額費用がかかる | 部署単位で継続的に運用したい |
クラウドの検索・AI基盤で自社構築する | 自由度が高く、既存システムと連携しやすい。開発と保守の体制が必要 | 全社規模で使う、機密性の高いデータを扱う |
どの方法でも、入力した社内データの扱い(学習への利用の有無、保存場所)が自社の規程に合っているかを、導入前に情報システム部門と確認しておきましょう。
RAG・LLMに関するよくある質問
Q. RAGとChatGPTの違いは何ですか?
A. ChatGPTはLLMを使ったAIサービスの名前で、RAGは「検索してから回答を生成する」仕組みの名前です。比べる階層が異なります。ChatGPTの検索機能のように、サービスの中にRAG型の仕組みが組み込まれていることもあります。
Q. RAGとファインチューニングはどちらを選ぶべきですか?
A. 社内の情報や最新の情報を正しく答えさせたいならRAG、回答の文体や出力形式をそろえたいならファインチューニングが向いています。情報が頻繁に変わる業務では、再学習が要らないRAGのほうが運用しやすいのが一般的です。両方を組み合わせることもできます。
Q. RAGの欠点は何ですか?
A. 回答の質が検索の精度と参照データの質に左右されることです。的外れな文書を取り出すと回答も的外れになり、古いデータを参照すれば古い答えが返ります。データの整備・更新とアクセス権の管理を続ける体制が必要です。
Q. RAGを導入すれば、ハルシネーションはなくなりますか?
A. なくなりはしません。根拠となる資料を渡すことで起きにくくはなりますが、資料の読み違いや、資料にない内容を補ってしまうことは起こり得ます。重要な回答は参照元を人が確認する運用にしましょう。
Q. 自社サイトをAI検索に引用されやすくするには、何から始めればよいですか?
A. まずは見込み顧客がAIに投げそうな質問を実際に試し、自社が言及されるか、どのページが引用されているかを記録して現状を把握します。そのうえで、検索で評価される記事の土台づくりと、一次情報・出典の追加を優先して進めるのがおすすめです。
【AIに「選ばれる」企業へ。】
RAGの理解が、AI時代に「選ばれる」コンテンツ設計の出発点になる
LLMは学習済みの知識で答えるAIモデル、RAGはLLMに「調べてから答えさせる」仕組みです。社内で使えば、最新の社内情報にもとづく回答で業務を効率化できます。そして同じ仕組みが、GoogleのAI検索やChatGPTの検索機能にも組み込まれています。AIの回答に自社が登場するかは、検索で取り出され、答えとして使いやすく、信頼できる情報源と判断されるかで決まります。
Habinyでは、複数業界のSEO支援で得た実データをもとに、検索で評価される土台づくりと、AI検索で引用される中身づくりを一体で設計し、問い合わせや商談につなげる支援を行っています。「AI検索で自社がどう見えているか知りたい」という段階からでも、お気軽にご相談ください。
【AIに「選ばれる」企業へ。】